当读者是 Agent,内容的最小单位不再是文章
从可发现到可验证,拆解内容方要为 Agent 使用知识解决的七个问题,并提出用结构化摘要、判断与证据实现渐进式加载。
TL;DR
Agent 能读取文章,不等于能正确使用文章里的知识。 要让内容面向 Agent,内容方需要解决可发现、可定位、可理解、可关联、可追溯、可演化和可验证七个问题。 文章提出用结构化摘要承担渐进式加载,让 Agent 按主题目录、文章摘要、相关判断和原文段落逐层取用。 对人,文章仍是理解的单位;对 Agent,带来源、时间、状态和责任人的判断可能更适合作为知识使用的基本单位。
目录
开篇
Stripe 联合创始人 John Collison 的一篇访谈摘要中有一个判断让我印象很深:产品的用户正在发生变化,越来越多工作由编程 Agent 完成。
把文章给 Agent 读,最容易想到的就是把网页转成 Markdown,提供 JSON、API 或 MCP,让 Agent 能够读取。
但能读取只是第一步。
Agent 能读到文章,不等于它能正确使用文章里的知识。
最近我自己做了一些实践,逐渐梳理出七个问题:要让内容更好地被 Agent 使用,内容方还需要做好哪些工作?
可发现 → 可定位 → 可理解 → 可关联 → 可追溯 → 可演化 → 可验证这里先划清一个边界:下面讨论的是「内容方」怎样治理知识库,负责让判断有准确的来源、适用范围、版本和可读取的接口。负责怎样检索这些材料、形成答案,以及验证答案中的推理与引用的是「Agent 方」。
知识库维护好了,并不代表任何 Agent 都能答对。但缺少这些基础,下游每次回答都得重新判断内容的新旧、证据的位置……而这些部分本可以由内容方维护一次,再被多次复用。👇
1、可发现
当内容越来越多,Agent 能不能找到真正需要的内容?
这其中至少包含三件事:
- 提供目录和入口,让 Agent 有机会发现这个内容源,并知道从哪里开始读取;
- 提供关键词、语义描述、时间、作者和主题信息,支持下游缩小范围;
- 说明内容覆盖了什么、尚未覆盖什么,并区分「本次检索没有命中」和「这个知识库明确没有相关立场」。
一次搜索没有结果,并不能证明作者从未谈过。知识库应该尽量提供覆盖信息和检索边界;Agent 依据这些信息决定是否继续查找,并对最终说出的「没有答案」负责。
2、可定位
找到文章之后,Agent 能不能定位到真正支持答案的部分?
一篇长文可能同时包含新闻事实、背景资料、他人观点、作者判断和暂时性的猜想。Agent 如果每次只能取回整篇文章,就要在大量无关上下文中重新判断哪些句子有用,也更容易发生断章取义。
这就意味着内容内部也需要稳定地址:
- 每一段有可引用的锚点;
- 每一条重要判断有不会随标题变化的 id;
- 表格、列表和引文不会在转换过程中丢失结构;
- Agent 可以只取回 p7 到 p10,而不是把三万字全文塞进上下文。
段落地址还需要和版本对应。比如 p7 这样的顺序编号,在正文插入新段落后可能就指向别处。长期证据引用需要版本号、内容快照或更稳定的段落 id,才能防止链接能打开、内容却已经变了。
这些不只是为了解决 token 成本问题,更是让系统可以定位得更精准。
3、可理解
定位准确,也不等于理解准确。
例如,一篇文章里同时出现下面五句话:
- 某家公司发布了一个新模型;
- 这个模型在某项评测上超过上一代;
- 作者认为这意味着应用层机会正在增加;
- 作者建议创业者近期重点关注这个方向;
- 作者也承认,这个判断还缺少真实用户数据。
它们分别是新闻事实、需要核对口径的数据、作者判断、针对特定人群的建议,以及对不确定性的限定。
对于内容很多的情况下,要让 Agent 都能正确理解,一条内容至少需要回答:
- 这是谁说的,是作者本人、引用对象,还是模型的综合?
- 它是事实、判断、假设,还是已经被推翻的旧观点?
- 它在什么时间、什么对象和什么条件下成立?
- 作者对它有多大把握?
- 这是未经确认的候选内容,还是作者愿意公开认领的立场?
这也是为什么,对于 Agent 的检索、比较、引用和更新,带有作者、性质、时间、状态和适用范围的判断,更适合作为基本操作单位。
4、可关联
大量文章真正困难的地方,不是每一篇能不能单独读懂,而是它们之间能不能连起来。
传统网站通常用标签、分类和相关文章来表达关联。但 Agent 需要的关系要精确得多:
- A 是 B 的证据;
- A 支持或增强了 B;
- A 和 B 看似冲突,但适用范围不同;
- B 是 A 的前提;
- 新判断 C 取代了旧判断 B;
- ……
这些都是带类型的语义关系。
Micropublication 很早就在科学出版中讨论过类似问题:一篇线性文档背后,其实包含主张、证据、解释以及支持和反驳关系。Wikidata 背后的 Wikibase 数据模型 也不会只保存「对象—属性—值」,还会为每条 statement 增加限定条件、来源和优先级。
这些研究给到的启发是,对于 Agent,关联的价值在于说明内容之间的关系:是支持、补充、冲突,还是存在不同的适用条件。
5、可追溯
这里追溯的对象,首先是知识库里的判断。
内容方需要回答:这条判断来自哪篇文章、哪些段落?引用的是哪个版本?由谁提出和确认?确认发生在什么时候?它后来有没有被修正或取代?
当 Agent 用这些判断生成答案时,又产生了另一条追溯链:这次回答用了哪些记录,哪些句子是原文,哪些是模型综合,引用能否支持生成的结论。这条链由 Agent 方建立。👇
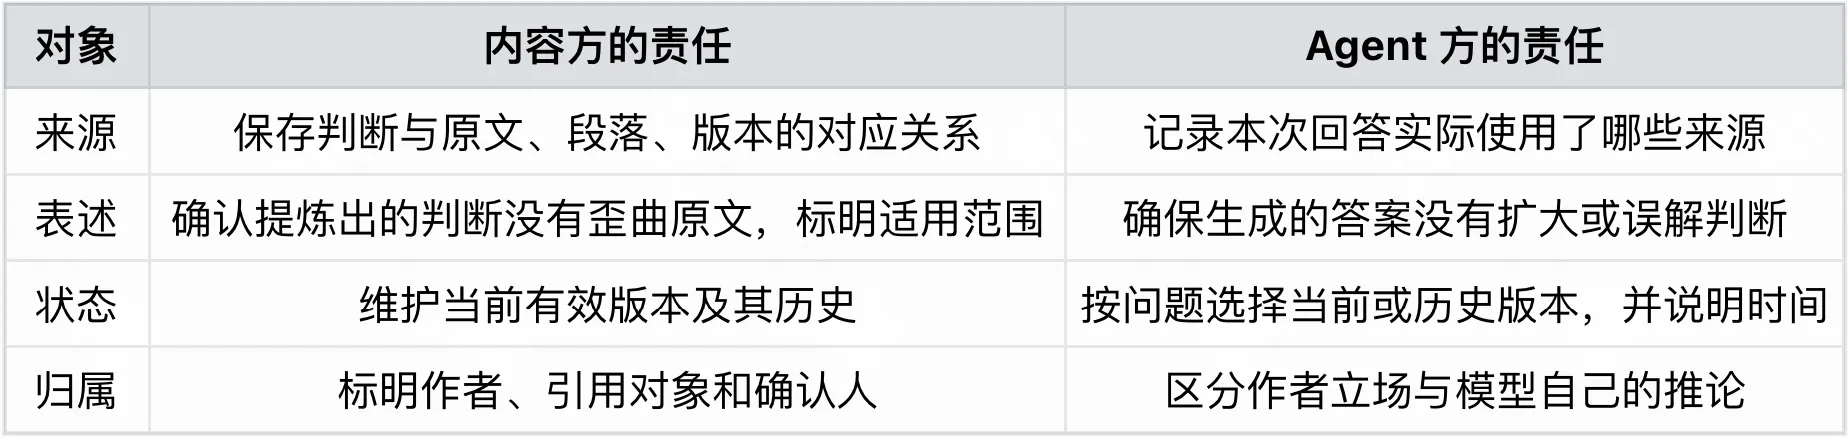
内容方不能把错误摘要交出去以后要求 Agent 自己纠正,但也不必为任意 Agent 的每一次发挥背书。双方要对自己生产和维护的那一层负责。
6、可演化
传统内容系统默认只做一件事:不断追加。
今天发布一篇,明天再发布一篇。旧文章仍然存在,但很少会回去标记其中哪些判断已经变化。
新内容进入系统以后,不能只是多一条记录:
新内容进入 ↓提出候选判断 ↓寻找可能受影响的旧判断 ↓判断关系:支持 / 补充 / 冲突 / 缩小范围 / 取代 ↓由作者或负责人确认 ↓更新当前观点,同时保留历史这里有一条重要的原则是:不要让模型直接改写历史文章。
文章记录的是我在那个时间写过什么,不应该因为今天改变看法就被重写。真正需要更新的是文章之上的当前判断层:新判断可以通过 supersedes 取代旧判断,旧判断仍然保留,系统默认返回当前有效版本,同时允许人和 Agent 查看观点是怎样变化的。
因为变化本身也是知识。
7、可验证
知识库的可验证,首先是能检查自己提供的记录和接口。
- 判断 id 是否唯一;
- 来源链接和证据段落是否存在;
- 保存的引文是否与对应版本的原文一致;
- 提炼时是否遗漏了关键限定、混淆了作者归属;
- 取代关系有没有断链、循环或互相矛盾的状态;
- ……
其次可以选定一个参考 Agent,用固定问题比较普通网页、全文 Markdown、段落检索和结构化判断。用这种对照实验来判断治理投入是否值得。
人工修改率、复核积压和每篇维护时间,同样应该记录。知识库要能长期维护,才有持续使用的价值。
七个问题解决以后,可以得到什么
如果把这七层连起来,内容的形态就会发生变化:
原始材料与历史文章 ↓供 Agent 选择阅读对象的结构化摘要 ↓可定位的段落与证据 ↓带作者、时间、性质和范围的判断 ↓判断之间的支持、冲突和取代关系 ↓经过确认的当前观点 ↓按公开、会员和内部权限提供给 Agent ↓持续检查记录、关系、索引和权限至少包含这六个相互配合的层次:
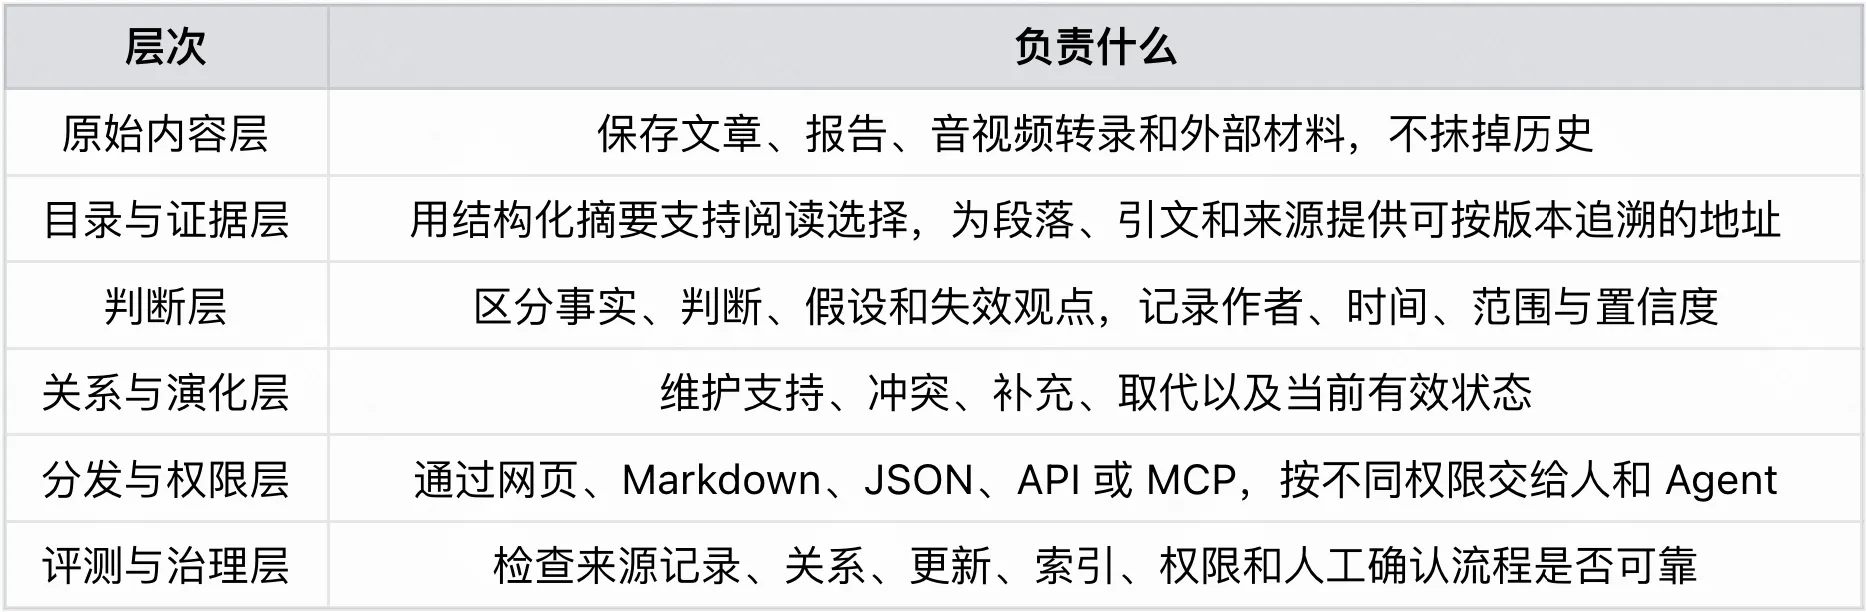
这时,内容就从一次性阅读产品,变成了一种可以持续查询、更新和授权的判断资产。
一个具体入口:让摘要承担渐进式加载
在这过程中,突然联想到是否可以借鉴 Skill 的渐进式加载思路,为每篇文章提供一份面向检索的「文章说明书」,帮助 Agent 决定是否继续读取,以及从哪里开始读。
普通摘要是告诉读者这篇文章讲了什么,但这个面向 Agent 的摘要说明书还需要帮助它决定:遇到什么问题应该读这篇,哪些问题不在覆盖范围内,里面有哪些可引用的判断,下一步去哪里取证据。
主题目录 → 少量候选文章的结构化摘要 → 相关判断 → 对应版本的原文段落以这篇文章为例,结构化摘要是不是可以先设计成这样:
id: agent-era-content-unit-is-judgmentdescription: 讨论面向 Agent 的内容治理、渐进加载和判断生命周期questions_answered: - 知识库怎样帮助 Agent 选择值得读取的文章 - 内容方与 Agent 方怎样划分追溯责任 - 新文章进入后怎样复核旧判断coverage_limits: - 不提供 MCP 服务端实现教程 - 会员授权部分尚未经过真实试点claim_ids: - seven-properties-of-agent-ready-content - agent-content-infrastructure-is-a-lifecycleread: markdown: /writing/agent-era-content-unit-is-judgment.md paragraph_tool: get_article元数据的数量由阅读决策决定。主题、问题、覆盖边界和读取地址有助于路由;判断的性质、证据和有效状态,则可以在下一级按需读取。内容规模扩大以后,文章摘要也需要经过主题筛选,避免把全部摘要重新塞满上下文。
但是结构化摘要本身也是有损压缩,因此需要保留直接搜索正文的路径。
这样,摘要帮助 Agent 决定读哪里,判断提供可复用的观点,证据支持核实与引用,版本关系说明这些观点如何变化……🤔
最后
文章不会消失。人仍然需要完整的叙事,需要理解一个判断是在什么背景下形成的,通过作者的语气、论证和取舍建立信任。
但当内容作为被 Agent 反复检索、比较、引用和更新时,文章就不再适合作为唯一的知识容器。
对人,文章仍然是理解的单位;
但对 Agent,带来源、时间、状态和责任人的判断,可能更适合作为使用知识的基本单位。
但这需要一整套关于发现、定位、理解、关联、追溯、演化和验证的长期工作。内容方把知识的来源、含义和变化维护清楚,Agent 方把这些知识用于具体任务。双方之间有一个清楚、可检查的交接。
但这套设计还只是起点。哪些信息值得单独维护,哪些环节可以简化,带来的收益能否覆盖维护成本,还都需要在后续的实践中逐一验证。
核心结论
标注「判断」「假设」的是我的看法而非事实;标注「已推翻」的保留在这里,不删除。
Agent 能读取一篇文章,只说明内容可以进入上下文,不代表它能找到、理解、关联并正确使用其中的知识。#
判断 · 把握较大 — 在 knowledge-base-is-upstream-of-memory 之上加了一层:知识库不只要归本人所有,还要让 Agent 能按需发现、定位并正确理解其中的知识。
查看出处与限定
本人已公开表达,沿用原有公开署名,不表示本次重新确认。
论述上下文 · p8 · 关系待复核
这里先划清一个边界:下面讨论的是「内容方」怎样治理知识库,负责让判断有准确的来源、适用范围、版本和可读取的接口。负责怎样检索这些材料、形成答案,以及验证答案中的推理与引用的是「Agent 方」。
论述上下文 · p9 · 关系待复核
知识库维护好了,并不代表任何 Agent 都能答对。但缺少这些基础,下游每次回答都得重新判断内容的新旧、证据的位置……而这些部分本可以由内容方维护一次,再被多次复用。👇
论述上下文 · p14 · 关系待复核
一次搜索没有结果,并不能证明作者从未谈过。知识库应该尽量提供覆盖信息和检索边界;Agent 依据这些信息决定是否继续查找,并对最终说出的「没有答案」负责。
这里只定位已有署名公开表达和论述上下文;未核验外部原始证据,不证明事实正确或本人重新确认了证据关系。
面向 Agent 的知识库需要提供可发现、可定位、可理解、可关联、可追溯、可演化和可验证的内容基础;下游 Agent 仍需对检索、推理和引用负责。#
判断 · 把握较大
查看出处与限定
本人已公开表达,沿用原有公开署名,不表示本次重新确认。
论述上下文 · p7 · 关系待复核
可发现 → 可定位 → 可理解 → 可关联 → 可追溯 → 可演化 → 可验证
论述上下文 · p8 · 关系待复核
这里先划清一个边界:下面讨论的是「内容方」怎样治理知识库,负责让判断有准确的来源、适用范围、版本和可读取的接口。负责怎样检索这些材料、形成答案,以及验证答案中的推理与引用的是「Agent 方」。
论述上下文 · p9 · 关系待复核
知识库维护好了,并不代表任何 Agent 都能答对。但缺少这些基础,下游每次回答都得重新判断内容的新旧、证据的位置……而这些部分本可以由内容方维护一次,再被多次复用。👇
这里只定位已有署名公开表达和论述上下文;未核验外部原始证据,不证明事实正确或本人重新确认了证据关系。
对人的理解而言,文章仍然重要;但对 Agent 的检索、比较、引用和更新而言,带有来源、时间、状态和责任人的判断可能更适合作为基本操作单位。#
假设 · 把握中等 — 在 opinions-need-stance-and-time 之上加了一层:把标明性质与时间的观点升级为可独立检索、引用和演化的判断单元。
查看出处与限定
本人已公开表达,沿用原有公开署名,不表示本次重新确认。
论述上下文 · p70 · 关系待复核
文章不会消失。人仍然需要完整的叙事,需要理解一个判断是在什么背景下形成的,通过作者的语气、论证和取舍建立信任。
论述上下文 · p73 · 关系待复核
但对 Agent,带来源、时间、状态和责任人的判断,可能更适合作为使用知识的基本单位。
这里只定位已有署名公开表达和论述上下文;未核验外部原始证据,不证明事实正确或本人重新确认了证据关系。
面向 Agent 的内容基础设施需要把原始内容、结构化摘要、证据、判断、关系演化、权限分发和持续验证连成一套可维护链路。#
判断 · 把握较大
查看出处与限定
本人已公开表达,沿用原有公开署名,不表示本次重新确认。
论述上下文 · p57 · 关系待复核
原始材料与历史文章 ↓ 供 Agent 选择阅读对象的结构化摘要 ↓ 可定位的段落与证据 ↓ 带作者、时间、性质和范围的判断 ↓ 判断之间的支持、冲突和取代关系 ↓ 经过确认的当前观点 ↓ 按公开、会员和内部权限提供给 Agent ↓ 持续检查记录、关系、索引和权限
这里只定位已有署名公开表达和论述上下文;未核验外部原始证据,不证明事实正确或本人重新确认了证据关系。
面向检索的结构化摘要可以借鉴 Skill 的渐进式加载思路,帮助 Agent 逐层选择主题目录、候选文章、相关判断和对应原文段落。#
假设 · 把握中等 — 在 skills-three-level-disclosure 之上加了一层:把 Skill 的渐进式加载思路扩展到文章摘要、判断和证据的分层读取。
查看出处与限定
本人已公开表达,沿用原有公开署名,不表示本次重新确认。
论述上下文 · p62 · 关系待复核
普通摘要是告诉读者这篇文章讲了什么,但这个面向 Agent 的摘要说明书还需要帮助它决定:遇到什么问题应该读这篇,哪些问题不在覆盖范围内,里面有哪些可引用的判断,下一步去哪里取证据。
论述上下文 · p63 · 关系待复核
主题目录 → 少量候选文章的结构化摘要 → 相关判断 → 对应版本的原文段落
论述上下文 · p66 · 关系待复核
元数据的数量由阅读决策决定。主题、问题、覆盖边界和读取地址有助于路由;判断的性质、证据和有效状态,则可以在下一级按需读取。内容规模扩大以后,文章摘要也需要经过主题筛选,避免把全部摘要重新塞满上下文。
论述上下文 · p67 · 关系待复核
但是结构化摘要本身也是有损压缩,因此需要保留直接搜索正文的路径。
这里只定位已有署名公开表达和论述上下文;未核验外部原始证据,不证明事实正确或本人重新确认了证据关系。
引用本文
晨旭,《当读者是 Agent,内容的最小单位不再是文章》,晨光里的AI,2026-10-19
[晨旭:《当读者是 Agent,内容的最小单位不再是文章》](https://chenxu.xin/writing/agent-era-content-unit-is-judgment)带进你的 AI 继续追问
这篇文章有一份干净的 Markdown 原文,可以直接交给任何模型读,不用复制粘贴。